
Pokedex to mój pierwszy większy projekt w JavaScripcie. Pisałem go równolegle z kursem – bez frameworka, na własnych klasach. Chciałem zrobić coś trudniejszego niż kolejną listę zadań i coś, czego nie znalazłem gotowego.
Pokemony wybrałem z prostego powodu: są od lat, więc ktoś na pewno zbudował już dla nich API. Tak było – PokéAPI wyskoczyło w wyszukiwarce jako pierwsze. Dane wprowadza ktoś inny, a ja mogłem skupić się na kodzie.
Problem: dane są w wielu miejscach
W PokéAPI każdy pokemon ma swój adres z kompletem danych. Najprostsza droga to jedno zapytanie na pokemona – tak robi większość tutoriali z pierwszą generacją. Przy ponad 1000 gatunków to ponad 1000 zapytań przy każdym wejściu na stronę. Bałem się, że to zbyt mocno obciąży serwer, a strona będzie się długo ładować.
Dlatego odwróciłem kolejność. Zamiast pytać każdego pokemona o jego typ, pytam każdy typ o jego pokemony:
- lista gatunków – jedno zapytanie daje numery i nazwy wszystkich pokemonów,
- typy – każdy typ zwraca listę pokemonów, które go mają,
- generacje – każda generacja zwraca listę swoich gatunków.
Zapytania o typy i generacje idą równolegle przez Promise.all. Do tego osobne zapytania o nazwy z myślnikiem – API zwraca np. mr-mime, a na liście chciałem mieć „Mr. Mime”. W sumie wychodzi kilkadziesiąt zapytań zamiast ponad tysiąca.
Mała baza w przeglądarce
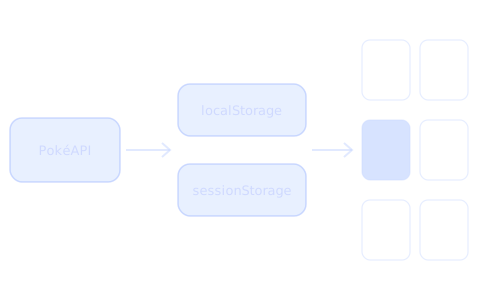
Z tych odpowiedzi składam jeden obiekt: numer pokemona → nazwa, typy i generacja. Klucze są jednoliterowe (n, t, g), bo całość trafia do localStorage, a tam miejsce jest ograniczone.
Przy kolejnej wizycie strona pyta API tylko o to, ile jest teraz gatunków. Jeśli liczba zgadza się z tą w pamięci, lista ładuje się z przeglądarki – to dwa zapytania zamiast kilkudziesięciu. Jeśli w API pojawią się nowe pokemony, baza zbuduje się od nowa sama. Tego chciałem od początku: żeby raz napisany kod działał dalej beze mnie.
Wzrost, waga i statystyki pobieram dopiero wtedy, gdy ktoś otworzy kartę pokemona. Trafiają do sessionStorage, więc drugie otwarcie tej samej karty nie wysyła już zapytania.
Co chwilę nowy pomysł
Sama lista szybko mi nie wystarczyła. W trakcie pisania co chwilę chciałem coś dodać:
- zaznaczanie złapanych pokemonów – lista zapisuje się w przeglądarce,
- import i eksport tej listy, żeby przenieść ją na inne urządzenie albo do innej przeglądarki,
- jasny i ciemny motyw,
- paginację z numerem strony w adresie, żeby link prowadził od razu w to samo miejsce.
Pomysłów było więcej niż czasu. Często zaczynałem kolejną rzecz, zanim poprzednia działała do końca tak, jak powinna – i potem wracałem do kilku miejsc naraz.
Błędy, które uczyły najwięcej
Na początku kilka razy wpadłem w pętlę, która przeciążała komputer. Potem przyszła asynchroniczność – musiałem sprawdzać, gdzie wysyłam zapytanie, co dostaję i czy te dane w ogóle są mi potrzebne. Najtrudniejsze okazało się zgranie tego z DOM-em: dane już są, a widok jeszcze nie, albo odwrotnie.
Moim głównym narzędziem był console.log i console.trace. Dziś częściej zatrzymałbym kod w debuggerze w miejscu, gdzie coś się dzieje – wtedy tego nie robiłem, a pewnie zaoszczędziłbym sporo czasu.
Co zrobiłbym dziś inaczej
- Kończyłbym jedną funkcję, zanim zacznę następną. Do pracy małymi krokami doszedłem dopiero po jakimś czasie.
- Najpierw przeanalizowałbym, jak API podaje dane i czego naprawdę potrzebuję, a dopiero potem pisał kod.
- Może najpierw zrobiłbym wygląd, a potem funkcje – wygląd zmieniałem wiele razy w trakcie.
- Nie wszystko musi być klasą. Niektóre części dziś napisałbym jako zwykłe funkcje.
Projekt nie wygląda na wielki, ale dla mnie był ważnym krokiem. Kiedyś chcę przepisać go na Vue – temat ten sam, nowa lekcja. Na razie Pokedex działa tutaj.